- 12 ~ 16일까지 딥러닝 관련 교육을 들었습니다.
- 교육 들으면 고개만 끄덕거리다 오는 경우도 많은데, 이번에는 꽤 재밌고 유익하게 배워서 도중에 필기한 것 남깁니다.
1일차: 딥러닝 기초
도구와 환경
스텔스모델: 모델은 비공개, 무료로 제공하여 데이터 수집
OpenCode: 여러 모델을 써보며 체험해보기 좋음
MNIST 데이터 셋, 손글씨 이미지 데이터
딥러닝 하드웨어
uv <- conda 로 환경설정 추세가 옮겨가고 있으나 아직 바이너리 관련 처리는 conda가 좋음
어떤 프레임워크를 쓸 것인가?
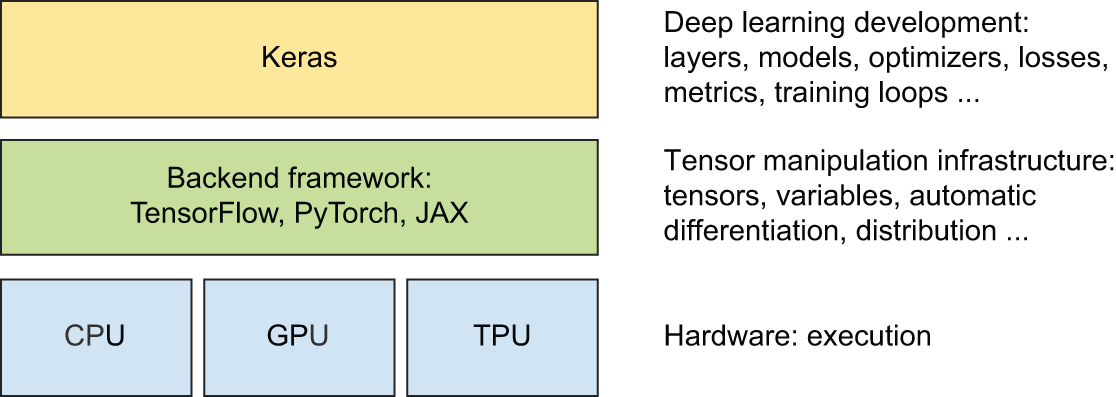
일반적인 SW에서는 파이썬 인기가 시들해지고 있다. 인간친화적일 필요가 없어지고 있기 때문
Keras: Dense <-> torch: Linear, Unit 이라고 부른다.
활성화 함수
Why ReLU?
- Dense는 선형만 계산해서 아무리 쌓아도 하나의 선형 변환이다. 비선형 관계를 표현하려면 비선형 함수를 추가한다.
- 계산이 빠름
- sigmoid 에 비해 기울기 소실(Vanishing Gradient) 문제가 완화됨
- 단, 입력이 음수면 기울기가 0이라 뉴런이 죽는 문제(Dying ReLU)가 있음
Softmax
- 확률화 기능
- 해당 층 뉴런 확률합이 1, 포함되는 클래스 판단
- 이진 분류나 다중 레이블(여러 클래스가 동시에 참) 판단은 sigmoid
손실 함수와 옵티마이저
Loss Function
- 문제 유형에 맞는 것 쓰면 됨
학습률 = 학습속도
- 외부변수라 정해 줘야 함
- 적응형 학습률로 개선됨
모멘텀
- 이전에 가던 방향을 기억하자
- Adam(옵티마이저)을 쓰기 시작하면서 사실 고려할 필요가 없어졌음 (Adam에 모멘텀이 내장됨)
배치와 데이터
batch와 sample은 다름, batch 사이즈는 대표성을 가질 수 있을 정도가 되어야 함
GPU 메모리가 batch 상한선을 정한다.
- 샘플 1개씩 처리하면 너무 느리다
raw 데이터 boxplot() 그리기, 데이터 특성 확인
- 경사하강 특성에 맞게 단위정규화 필요한지 확인
층을 쌓는다는 것
- ReLU
- 입력을 죽이거나 살리기 때문에, 평면에서 보자면 일직선으로 가던 것에 접힌 꺾은선을 하나 추가한다고 생각하면 됨
- 층이 더 쌓인다는 것?
- 평면에서 봤을 때, 한번 더 세밀하게 깎아 내는 것
기타
keras.backend.clear_session()
2일차: 다중 분류
다중 분류 기본
마지막에는 분류하고자 하는 N개의 뉴런(클래스)으로 끝나야 함
PIL(Pillow): 파이썬 이미지 전처리 라이브러리
이미지 = tensor = ndarray
훈련: 수많은 샘플을 보며, 오차가 줄어드는 방향으로 파라미터를 조율해나가는 과정
문제 유형별로 정해지는 것들
| 결정할 것들 | How | 틀리면 |
|---|---|---|
| activation Func | 유형별로 거의 고정 | 결과가 명확히 이상 |
| loss Func | " | 결과가 명확히 이상 |
| hidden layer activation func | 기본:ReLU | 차이 적음 |
| Optimizer | 기본: Adam | 차이 적음 |
| Learning rate | 1e-3에서 출발 | 발산 or wrong |
| preprocessing | 데이터에 의존적 | 진행 안됨 |
| 모델구조(층수, 뉴런수, 모델) | 데이터에 의존적 | 제일 중요 |
최적의 레시피를 찾는 것이 신경망 모델링의 과정
Loss 값이 0 ~ 1 로 정규화 (min-max 스케일링) 되는 것은 아님
모델 구조
Flatten 을 모델 내부에서 해야하는가?
- 그게 나음, 전처리에서 할 정도로 비용이 크지도 않고 모델에서 처리하는 것이 더 유연한 구조를 만듦
- 데이터가 큰 경우 메모리 관련 문제도 생김
심층 신경망(딥러닝)의 조건
- 2개 이상의 은닉층 (입력층과 출력층 사이의 층)
- 비선형 층이 있어야 함
더 나은 모델 만들기
최적적합 모델이 되려면 우선 과대적합이 되어야 한다.
- 필수 조건이라기보단 실무 전략: 먼저 과대적합될 만큼 용량이 충분한지 확인하고, 그 다음 규제
훈련이 잘 되지 않은 경우
- 학습률 조절 <- 요즘에는 Adam이 파라미터별로 조정해줌, 단 기본 학습률(1e-3)은 여전히 중요
- 배치 크기 증가(현재 사이즈가 대표성을 잘 나타내고 있는지?)
- 곡선을 잘 맞추기 위한 적절한 사이즈
- 딥러닝 향상의 No.1 개선 방법은 더 품질 좋고 많은 데이터!
- 모델 용량 늘리기 - 은닉층 넣으면 됨
과대적합의 지표 (일반적으로 모델이 과하기 때문에 발생)
- train acc는 계속 오르는데 val/test acc는 정체되거나 떨어짐 (격차가 벌어짐)
- validation data를 통해 Epoch 별 Loss 로 과대적합 확인 가능
분류와 회귀
객체 탐지 = 회귀(박스 좌표) + 분류(클래스), 경계선 뽑아내기 = 분류(픽셀 단위), 언어모델 = 분류(다음 토큰)
비선형 구조에서 크게 개선된다? <- 데이터의 비선형성이 강하다
val_loss 가 튀는 경우
- 이상치가 있다
- 데이터 개수 부족
기타
Symbolic tensor(Keras, 규격, 형식) vs Data Tensor(torch)
계산 그래프?
데이터 폴더는 읽기전용으로 두는 것이 편함
3일차: 합성곱(Convolution)
왜 합성곱인가
완전연결, Flatten
- 유닛이 너무 많고, 불필요한 부분도 집중하게 됨
- 공간을 이해하지 못함
Convolution 합성곱
- 필요한 부분에만 집중할 수 있음
강사 말: 기법이 시간이 흐르면서 변해왔지만, 중요한 것은 ‘무엇에 집중할 것인가?’ 였다
- 최소연결 (지역 연결, local connectivity: 근처 영역에만 연결)
- 커널(매개변수, 필터) 공유
풀링
- 최대 풀링 연산, MaxPooling
- 작은 변화에 민감하게 반응하지 않도록
- 강건한 시스템을 만들기 위해
데이터 처리
- 데이터 전처리 부분은 직접 구현하는 것이 나음
- 라이브러리 버전을 변경하면 문제가 많이 발생하기 때문에 딱 고정하여 구현해놓은 것이 나음
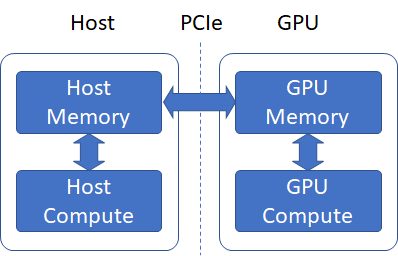
- CPU(Host) 메모리 → GPU 메모리로 데이터 옮기기
- 시간 소모됨
- 계산하는 도중에 데이터를 옮길 수 있도록 num_worker로 효율화
훈련 팁
훈련 점수가 100점이라면 모델 용량은 충분한 것
- 해결: 데이터 수 늘리기
train_acc, val_acc가 괜찮더라도 train_acc가 아직 오르는 중이면 (underfit) epoch을 늘려 볼 만하다
학습이 길어지면 체크포인트 활용
자주 쓰는 층
BatchNormalization: 층이 깊어질수록 선행 매개변수의 영향이 커짐, 정규화하여 그것을 방지(미니배치마다 평균 0, 분산 1로 표준화), 신호규격화
Residual Connection: 이미지뿐만 아니라 공통적으로 많이 쓰임
사전 훈련된 모델과 전이학습
사전 훈련된 모델(pretrained model)
- 풀고자 하는 문제에 사전 훈련된 모델이 있는지 확인하는 것이 우선
전이학습
- 해당 모델에 동일한 전처리 적용해야 함, Input 맞추기
fine tuning, 파인튜닝
- 일부 layer trainable = True
- 출력층에 가까워질수록 출력에 영향 많이 줌 (문제에 특화된 특징을 담기 때문)
- 출력층 쪽(위쪽) 층부터 조금씩 풀어보며 진행할 것
- 아래쪽 층은 엣지, 질감 같은 범용 특징이라 그대로 두는 게 나음
4일차: 세그멘테이션, 객체 탐지, 시계열
이미지 세그멘테이션
stride = 2인 Conv2D, 다운 샘플링 효과도 같이
- why 그냥 MaxPooling 안하고? 픽셀의 공간적 정보를 더 유지하기 위함
- MaxPooling은 영역 내 최댓값만 남겨 위치 정보를 버림, 세그멘테이션은 픽셀 위치가 중요
- why 그냥 MaxPooling 안하고? 픽셀의 공간적 정보를 더 유지하기 위함
인코딩 -> 디코딩, why? 이미지 사이즈가 정답과 같아야 분류하니까
Metric은 IoU 사용
why 마스크전처리?
- 사이즈 맞추기, 그리고 마스크는 annotation 값임
객체 탐지
- 백본모델: 출력이 지정되지 않음 (출력층을 떼어 낸 특징 추출기, 문제에 맞는 head를 얹어 사용)
- 사전 훈련된 모델: RetinaNet
시계열
- 데이터 검증 필수
- 데이터 정규화(경사하강 잘 되도록)
기타
여러모로 keras가 편하다
ZeroShot 모델: 추가 학습 없이 처음 보는 클래스나 작업에 바로 사용하면 되는 모델
그럼 신경망 모델링은 Layer의 역할만 이해하고 문제의 유형에 맞게 구성만 하면 되나?
- 맞음, 레이어별 동작은 정형화됨
5일차: 합성곱 정리, RNN, 트랜스포머
모델링 원칙
최소한의 신경망에서 동작하는지 보고, 그 다음에 확장할 것
경험상 Dense의 개수는 2k를 잘 넘어가지 않는다.
합성곱 정리
- 합성곱
- 패턴을 찾아내는데 유용한 연산이다
- 연산 결과로 보면 차원이 한 단계 낮아진다
- 필터 하나 기준: (높이, 너비, 채널) 영역 → 숫자 하나, 채널 축이 합쳐져 2D 맵이 됨
- 필터 여러 개를 쌓으면 다시 3D, 텐서 차원 수는 유지되고 크기만 줄어듦
- ‘평행이동 불변성’을 갖는다
- 엄밀히는 등변성(입력이 이동하면 출력도 이동), 불변성은 풀링과 함께 생김
- (전체 순서, 위치)가 중요한 데이터에는 적합하지 않을 수 있다
- 주변만 보고 위치에 상관없이 같은 패턴을 찾기 때문, 1D Conv로 시계열·텍스트에 쓰기도 함
RNN
현재 상태를 알기 위해서는 과거의 상태가 필요
- 그래서 병렬처리가 안 되고 직렬처리만 된다.
- 따라서 빠르게 처리할 수 없다
- 직렬처리가 많기 때문에 기울기가 사라지거나 폭발할 수 있다
아마존에서 미는 모델류이다 (DeepAR 등 RNN 기반 시계열 모델)
- AutoGluon(아마존의 AutoML 라이브러리)으로 써봤는데 baseline만 못함
- 이미지와 달리 직접 구현을 고려해야 하는 경우도 있다
텍스트 처리와 임베딩
transformer, 변환기
- 원래 목적이 번역(논문은 영어 -> 독일어/프랑스어, 수업 실습은 영어 -> 스페인어)
- 이해하기 위해서는 텍스트 처리에 대한 이해가 선행되어야 한다
인코더의 입력으로 임베딩을 기대하지만, 임베딩은 별도의 발견이다
임베딩
- 범주형 변수를 숫자로 표현하면 의도치 않게 대소, 순서의 관계가 생긴다
- One-Hot 인코딩: 벡터로 표현, 특성 공학의 일종
- 토큰화 정수 인코딩 -> 원-핫 인코딩
- 원-핫은 고차원·희소해 유사도를 못 담음 <-> 임베딩은 학습되는 저차원 실수 벡터, 비슷한 단어끼리 가까워짐
정규화는 특성 공학이 아니다
트랜스포머 구조
MultiHeadAttention: 연관 관계를 학습
인코딩은 입/출력이 같아서 반복 가능함 <-> CNN은 차원이 줄어들어 반복이 제한됨
- 디코더 블록은 수업시간에 구현 안해봄
단어수준 임베딩은 한계가 있음. 맥락과 위치가 더해져야 한다
GPT2
- 출력을 원하기 때문에 디코더로 구성됨
규모의 법칙
기타
if-else 를 벗어나 지능을 내장한 SW를 만들어야 성공할 수 있다
궁금한 건 디스코드 가능
- 교육 들으면서 가장 힘들었던 건 아무래도 숙박?, 선릉 너무 유흥이 발달했네요. 출장비로 묵을 만한 괜찮은 숙박업소도 없고